
En bref. Il y a 2 manières pour que ChatGPT vous cite : soit vous êtes déjà dans sa mémoire, soit il vous trouve sur Google. Quand la réponse n’est pas déjà dans sa mémoire, l’IA éclate votre question en sous-questions, va lire le web en direct et cite ce qu’elle y trouve de meilleur. Tout le travail consiste donc à être dans ce qu’elle lit à ce moment-là. Voici le mécanisme exact, puis la méthode en 7 étapes que j’applique sur mon propre site : audit de citations, accès des robots, sous-questions à gagner sur Google, structure extractible, chiffres propres, entité signée et signaux externes.
Sommaire
- Non, vous ne pouvez pas demander à ChatGPT de vous mentionner
- Comment une IA fabrique-t-elle sa réponse ?
- Étape 1. Êtes-vous déjà cité par les IA ?
- Étape 2. Vos pages sont-elles accessibles aux robots des IA ?
- Étape 3. Comment gagner les sous-questions que l’IA va se poser ?
- Étape 4. Comment structurer un contenu pour qu’une IA puisse l’extraire ?
- Étape 5. Pourquoi vos propres chiffres sont votre meilleur levier ?
- Étape 6. Pourquoi l’anonymat vous rend invisible ?
- Étape 7. Où les IA cherchent-elles en dehors de votre site ?
- Comment mesurer vos citations et le trafic venant des IA ?
- Les raccourcis qui ne marchent pas (dont le llms.txt)
- Combien de temps faut-il pour être cité par une IA ?
- Questions fréquentes
Non, vous ne pouvez pas demander à ChatGPT de vous mentionner
Désolé, je vais vous décevoir : ce n’est pas en lui demandant de vous mentionner que vous serez cité par ChatGPT. Une IA ne décide pas de vous citer parce que vous le lui avez demandé, elle vous trouve, ou elle ne vous trouve pas.
Aucune instruction donnée dans une conversation ne fera que ChatGPT vous cite ensuite auprès de quelqu’un d’autre. C’est le mythe que j’entends le plus souvent depuis un an, et il faut le tuer avant de parler de méthode, parce qu’il fait perdre du temps à beaucoup de monde.
Deux raisons, très simples. D’abord, ce que vous écrivez dans votre fil de discussion ne sort pas de votre fil de discussion : vous ne modifiez ni le modèle ni ce qu’il dira à un inconnu demain. Ensuite, quand le modèle va chercher sur le web, il ne consulte pas une liste de volontaires, il consulte les pages qui ressortent sur les questions qu’il se pose. Personne ne vend une place dans une réponse de ChatGPT, et vous pouvez vous méfier de ceux qui prétendent le contraire.
Je suis Fabian Delhaxhe, Growth Architect indépendant basé en Belgique. La bonne nouvelle, c’est que ce qui remplace la pensée magique est très concret, et que j’en ai la preuve sur mon propre site. En avril 2026, j’ai mis à jour ma page consultant growth marketing en y ajoutant le prix d’une prestation, jusque-là absent. Le lendemain, quelqu’un remplissait mon formulaire de contact pour une mission en citant ce prix, et en répondant « ChatGPT » à la question « comment m’avez-vous connu ? ». Je n’ai rien demandé à ChatGPT. J’ai simplement rendu une information précise lisible et extractible sur une page qu’il pouvait atteindre.
Pour comprendre pourquoi ça a marché, il faut regarder sous le capot.
Comment une IA fabrique-t-elle sa réponse ?
Quand vous posez une question à une IA, elle emprunte l’une de deux voies. Soit la réponse est déjà dans sa mémoire interne, c’est-à-dire dans les données sur lesquelles elle a été entraînée, et elle répond directement sans aller voir le web. Soit la question est fraîche, locale ou comparative. Et elle part chercher en direct.
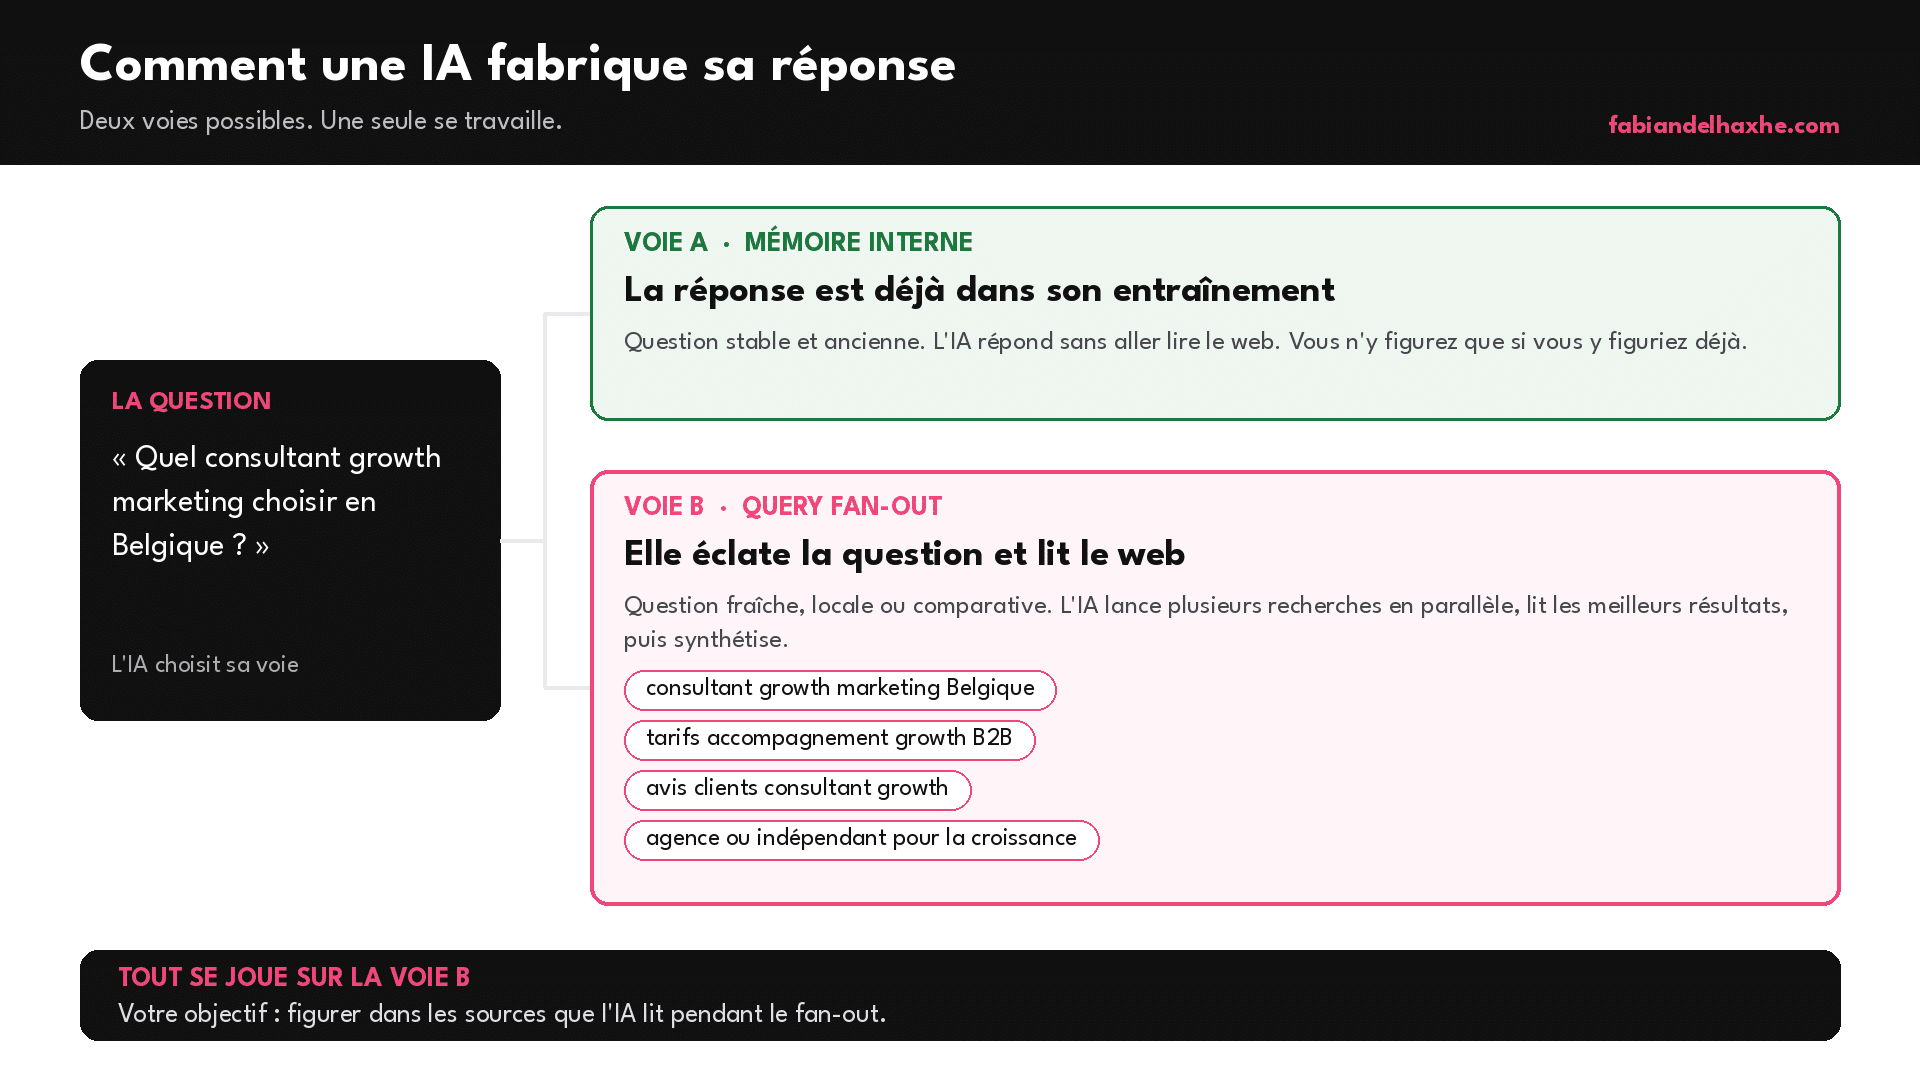
Cette deuxième voie porte un nom, et ce n’est pas du jargon d’agence : Google l’emploie dans sa propre documentation. Dans sa page consacrée aux fonctionnalités d’IA et à votre site web, l’entreprise écrit que les AI Overviews et le mode IA peuvent utiliser une technique de « query fan-out », qui consiste à lancer plusieurs recherches connexes sur des sous-sujets et des sources différentes. Traduction : votre question « quelle agence growth choisir à Bruxelles ? » devient en coulisse une dizaine de recherches du type « agences growth marketing Bruxelles », « avis clients 2026 », « tarifs accompagnement growth Belgique » et la réponse finale est une synthèse de ce que ces recherches ont ramené.
Deux conséquences qui commandent tout le reste de cet article. La première, c’est que la voie A vous est largement fermée : vous ne décidez pas de ce qu’il y a dans le corpus d’entraînement d’un modèle, et vous n’y entrez qu’en étant déjà abondamment présent sur le web depuis longtemps. La seconde, c’est que la voie B, elle, est entièrement jouable, parce qu’elle passe par des recherches classiques. Être cité par une IA, c’est d’abord être bien placé sur les sous-questions qu’elle va se poser à votre sujet.
C’est pour ça que je dis à mes clients que le référencement dans les IA est une surcouche du SEO, pas une discipline parallèle. Google le confirme d’ailleurs sans détour dans son guide officiel sur l’optimisation pour ses fonctionnalités d’IA générative : les bonnes pratiques de référencement restent valables, parce que ces fonctionnalités s’appuient sur les mêmes systèmes de classement et de qualité que la recherche classique. Si vous voulez le cadre général avant la méthode, j’ai détaillé ce que recouvre l’optimisation pour les moteurs génératifs dans un guide dédié.
Un mot sur le périmètre de cet article. Je parle de ChatGPT, de Claude et du mode IA de Google, qui est propulsé par Gemini, parce que ce sont les moteurs qui comptent vraiment pour une audience belge francophone et française. Perplexity existe et applique les mêmes principes, mais son usage reste marginal de ce côté-ci de l’Atlantique : je ne l’évoquerai qu’au passage.
Étape 1. Êtes-vous déjà cité par les IA ?
Vous ne le saurez qu’en posant vous-même les questions, de façon cadrée. Il n’existe aujourd’hui aucun outil qui couvre tous les moteurs génératifs comme la Search Console couvre Google, donc le point de départ est un audit manuel. Ce qui le rend utile, ce n’est pas de tester, c’est de tester toujours la même chose.
Construisez un jeu de 15 à 20 questions, réparties en quatre familles, et n’y touchez plus :
- Les questions de problème : ce que votre client tape quand il ne vous connaît pas encore (« comment structurer une stratégie de croissance B2B »).
- Les questions de catégorie : « quels consultants growth marketing en Belgique », « à qui confier une stratégie LinkedIn B2B ».
- Les questions de comparaison : « consultant indépendant ou agence pour du growth marketing », « quel budget pour un accompagnement growth ».
- Les questions de marque : votre nom, celui de votre société, le nom de votre méthode.
Posez-les dans ChatGPT, Claude et le mode IA de Google, puis consignez le résultat dans un tableau unique. Les colonnes qui comptent :
| Colonne | Ce qu’on y note | Pourquoi |
|---|---|---|
| Date | Jour du test | Seule la série compte, pas le test isolé |
| Moteur | ChatGPT, Claude, mode IA de Google | Ils ne citent pas les mêmes sources |
| Question | Formulation exacte | Une variante change la réponse |
| Marque citée | Oui, non, indirectement | Votre résultat brut |
| URL reprise | La page exacte citée | Dit quelle page travaille pour vous |
| Concurrents cités | Les sources prises à votre place | Votre liste de cibles à comprendre |
| Type de source | Site, LinkedIn, annuaire, média, forum | Dit où porter l’effort |
Refaites l’exercice une fois par mois, le même jour, avec les mêmes questions. Un test isolé ne vaut rien : ces modèles varient d’une session à l’autre. Une série de six mois, elle, dessine une tendance que vous pouvez piloter. Et la colonne « concurrents cités » vaut souvent plus que la vôtre, parce qu’elle vous dit exactement quel contenu occupe la place que vous visez.
Étape 2. Vos pages sont-elles accessibles aux robots des IA ?
C’est la condition la plus bête et la plus fréquemment ratée : un robot bloqué ne peut rien citer. Avant toute optimisation éditoriale, ouvrez votre fichier robots.txt et vérifiez qui a le droit d’entrer.
La nuance que presque personne ne fait, et qui change tout, c’est que chaque éditeur utilise plusieurs robots aux rôles distincts, réglables indépendamment. Voici ce que disent les documentations officielles des 3 moteurs qui nous intéressent :
| Moteur | Robot de recherche (à autoriser) | Robot d’entraînement | Robot déclenché par l’utilisateur |
|---|---|---|---|
| ChatGPT (doc OpenAI) | OAI-SearchBot | GPTBot | ChatGPT-User |
| Claude (doc Anthropic) | Claude-SearchBot | ClaudeBot | Claude-User |
| Mode IA de Google (doc Google) | Googlebot, le robot de la recherche classique | Google-Extended, qui ne concerne pas la recherche | sans objet |
Conséquence pratique, et c’est le point à retenir : vous pouvez refuser que votre contenu serve à entraîner les modèles tout en restant parfaitement citable. Il suffit de bloquer GPTBot et ClaudeBot, et d’autoriser OAI-SearchBot et Claude-SearchBot. Beaucoup de sites ont fait exactement l’inverse en 2024, en bloquant tout d’un bloc par prudence, et se sont rendus invisibles sans le vouloir. Côté OpenAI, la documentation précise qu’une modification du robots.txt met environ vingt-quatre heures à être prise en compte.
Côté Google, la condition tient en une phrase, et elle est écrite noir sur blanc : pour apparaître comme source dans ses fonctionnalités d’IA, une page doit être indexée et éligible à l’affichage d’un extrait dans la recherche, et il n’y a aucune exigence technique supplémentaire. Autrement dit, si vous utilisez la balise nosnippet pour empêcher Google d’afficher un extrait de votre page, vous vous excluez aussi des réponses IA. Si vous n’avez jamais vérifié tout ça, la Search Console est gratuite et répond en deux clics : j’ai détaillé la marche à suivre dans mon guide pour faire un audit SEO gratuit.
Étape 3. Comment gagner les sous-questions que l’IA va se poser ?
En traitant le query fan-out comme une liste de requêtes à couvrir, une par une, avec un contenu de fond. C’est l’étape que tout le monde saute parce qu’elle ressemble à du référencement naturel classique. Elle en est. Et c’est précisément pour ça qu’elle fonctionne.
La méthode est mécanique. Prenez une question de catégorie de votre audit, posez-la à une IA, et demandez-lui ensuite quelles recherches elle a effectuées pour y répondre : la plupart des moteurs vous les montrent. Vous obtenez la liste réelle des sous-questions. Vérifiez votre position sur chacune dans Google. Celles où vous n’êtes nulle part sont votre plan de contenu des 3 prochains mois, classées par proximité avec votre offre.
Ce lien entre autorité générale et citation IA est mesuré. Une étude SE Ranking a passé 2 328 533 pages et 295 485 domaines au crible sur plus de 500 000 requêtes dans le mode IA de Google, pour comparer les facteurs corrélés au fait d’être cité. Les deux premiers sont le trafic global du domaine et le nombre de domaines référents, loin devant la longueur du contenu. Les domaines qui reçoivent moins de 300 liens référents récoltent en moyenne 2,5 citations, contre 6,8 au-delà de 24 000. Sur ChatGPT, ce sont les domaines référents qui arrivent en tête.
Ce qu’il faut en retenir n’est pas « achetez des liens ». C’est qu’il n’existe aucun réglage propre à l’IA qui compenserait un site sans audience et sans notoriété. Les moteurs génératifs cherchent des voix crédibles, et ils les reconnaissent aux mêmes signaux que Google depuis vingt-cinq ans. C’est exactement ma thèse sur le growth hacking appliquée au référencement : un système durable bat un hack chaque fois qu’on regarde sur le moyen-long terme.
Étape 4. Comment structurer un contenu pour qu’une IA puisse l’extraire ?
En écrivant des passages qui se comprennent seuls. Un moteur génératif ne cite pas une page, il cite un extrait : votre unité de travail n’est plus l’article, c’est le paragraphe.
Sur les IA, les gens ne tapent pas des mots-clés comme sur Google, ils posent des questions et attendent une réponse toute faite. Et comme faire tourner ces modèles coûte cher, ils vont au plus efficace : ils prennent ce qui est déjà prêt à être repris. Les cinq règles que j’applique :
- Répondez dès la première phrase sous chaque titre, de façon autonome. C’est la pyramide inversée, et c’est ce que les modèles reprennent.
- Posez vos titres en questions. Les moteurs rapprochent la question de l’utilisateur de vos intertitres.
- Ouvrez par un résumé de trois à quatre phrases qui donne la réponse globale avant le développement, et terminez par une vraie FAQ.
- Choisissez le bon contenant : un tableau pour comparer, une liste pour une procédure, un paragraphe pour une nuance.
- Datez et nommez. Un passage qui porte sa source et sa date se cite sans risque pour le moteur, donc il se cite plus volontiers.
Le test que j’utilise pour trancher est bête et efficace : copiez un paragraphe de votre page dans un document vide. S’il répond encore à une question sans le reste de l’article, il est citable. S’il commence par « comme nous l’avons vu », il ne sortira jamais d’une réponse d’IA.
Un mot sur les données structurées, parce qu’on leur prête des pouvoirs qu’elles n’ont pas. Le balisage Article, FAQPage ou HowTo aide une machine à comprendre la nature de votre page, et je le pose systématiquement. Mais Google précise dans son guide que les données structurées ne sont pas un prérequis de ses fonctionnalités d’IA, même s’il continue de les recommander pour les résultats enrichis. Posez-les, ne comptez pas dessus pour compenser un contenu faible.
Étape 5. Pourquoi vos propres chiffres sont votre meilleur levier ?
Parce qu’un chiffre que vous êtes seul à publier fait de vous une source primaire, et qu’une source primaire se cite par définition. Tout le monde peut reformuler une étude. Personne d’autre que vous ne peut publier vos données de terrain.
C’est aussi ce que Google met en premier dans son guide : offrir un point de vue distinct ou une expertise de première main aura probablement plus d’effet à long terme que n’importe quel autre conseil de la page. Pas le balisage, pas la longueur. Le fait d’avoir quelque chose à dire que les autres n’ont pas.
La contrepartie est une discipline de rigueur non négociable : chaque chiffre que vous publiez porte sa source nommée, sa date et son périmètre. Un chiffre sans périmètre est inexploitable, pour un moteur comme pour un lecteur. Je m’applique la règle à moi-même : quand j’écris que plus de 80 % de mon activité vient de LinkedIn, que mon compte dépasse 24 000 abonnés et que j’ai accompagné plus de 100 entreprises dans ma carrière, ce sont des chiffres que je peux documenter.
Vous avez plus de données exploitables que vous ne le croyez : les résultats agrégés de vos missions, les constats récurrents de vos audits, un benchmark sectoriel que vous refaites chaque année, le délai moyen d’un de vos projets. Publiez-les proprement une fois, et vous devenez la page que les autres citent, machines comprises.
Étape 6. Pourquoi l’anonymat vous rend invisible ?
Parce qu’un moteur génératif cite plus volontiers une entité qu’il identifie sans ambiguïté qu’un site anonyme au contenu équivalent. Un article sans auteur, sur un site sans visage, ne donne au modèle aucune raison de le préférer à un autre.
Concrètement : signez vos contenus avec une vraie biographie d’auteur, nommez-vous dans le corps du texte et pas seulement dans le pied de page, tenez une page à propos qui dit qui vous êtes, et gardez la même dénomination et les mêmes coordonnées partout, sur votre site comme sur vos profils et vos fiches. Les rôles vérifiables aident beaucoup : dans mon cas, enseigner le marketing au Master en Entrepreneuriat de HEC Liège, coacher au StartLab Brussels et mentorer chez Start it KBC/CBC sont des éléments qu’un modèle peut rattacher à mon nom depuis plusieurs sources indépendantes.
Ajoutez un balisage Organization ou Person avec les liens vers vos profils officiels, qui lève l’ambiguïté sur votre identité. Et soignez vos avis clients : ils sont l’une des rares preuves externes de qualité qu’un modèle peut lire, et ils pèsent sur les questions de catégorie, celles où l’on vous compare à d’autres.
Étape 7. Où les IA cherchent-elles en dehors de votre site ?
Sur les plateformes où d’autres parlent de vous, avec LinkedIn tout en haut de la liste. C’est l’angle mort de la plupart des démarches : on travaille son site et on oublie que les moteurs vont massivement chercher ailleurs.
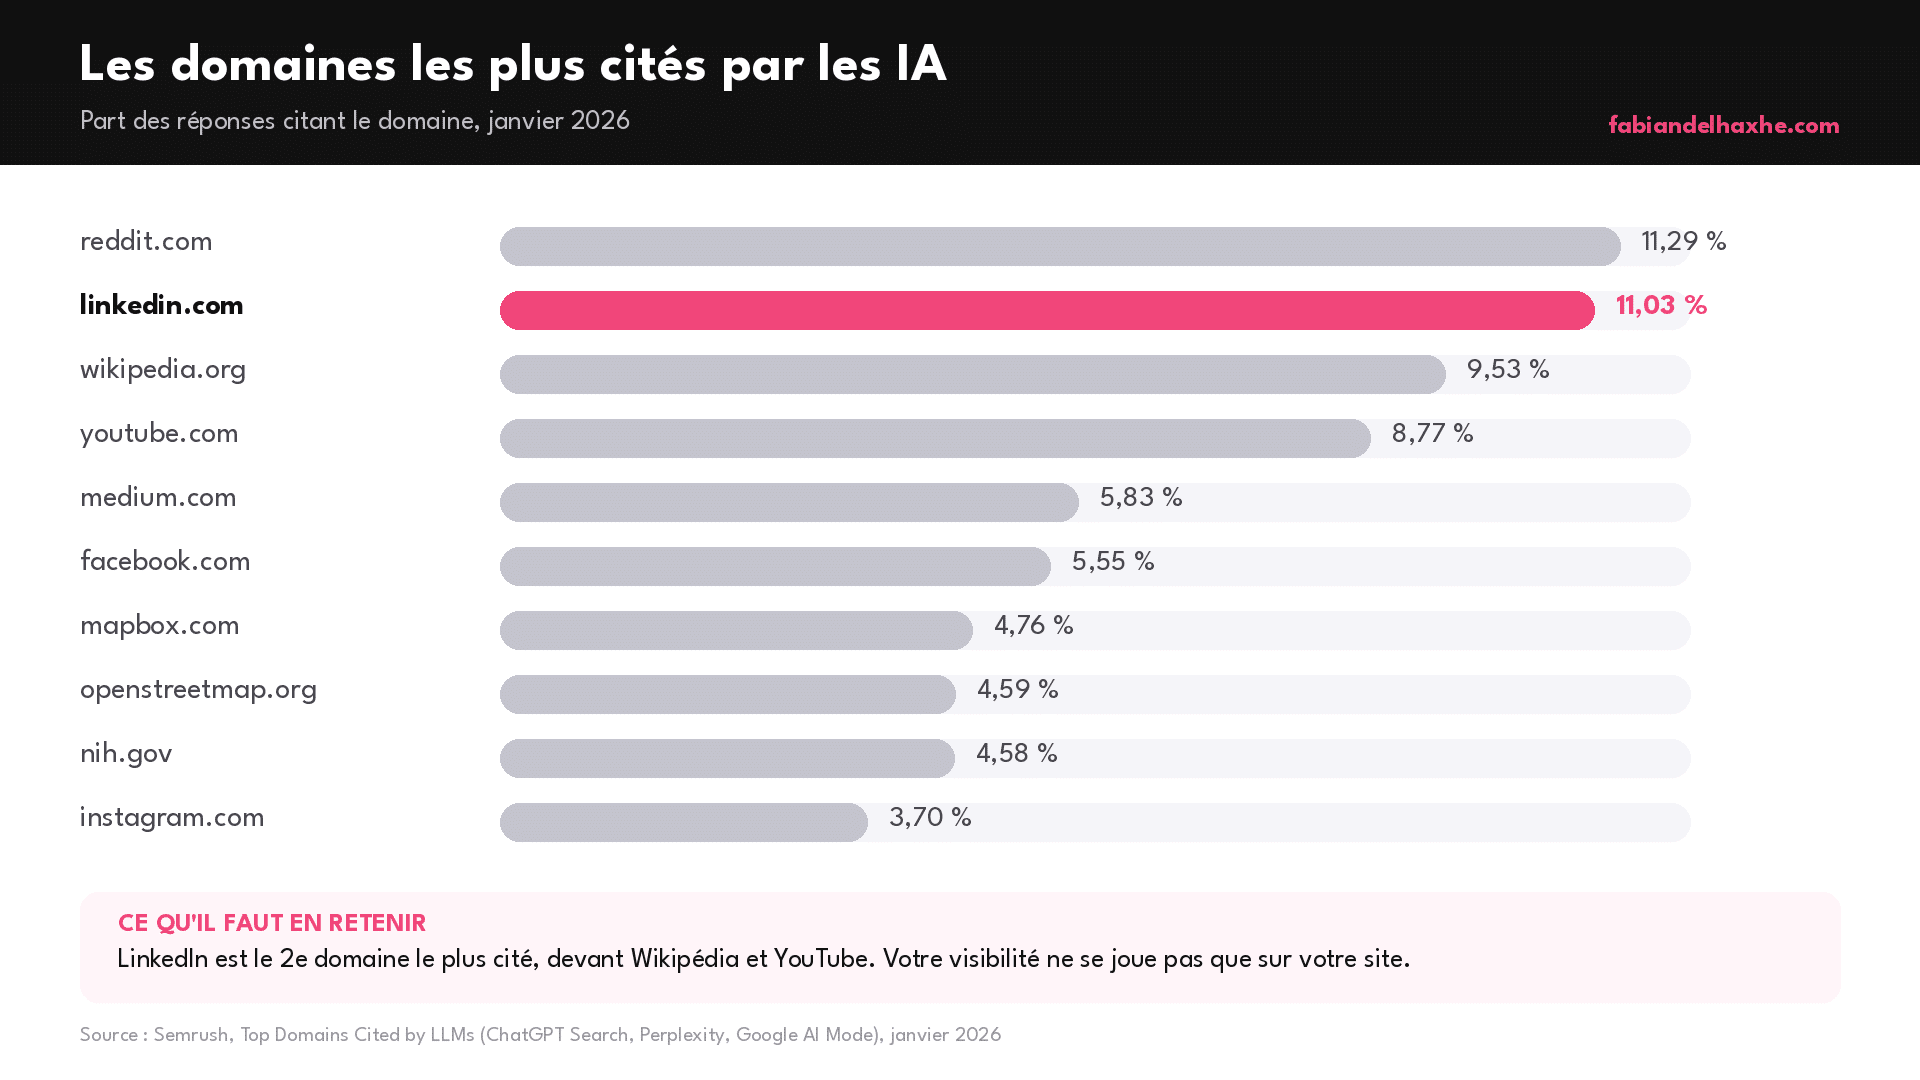
Une étude Semrush publiée en 2026, menée avec LinkedIn sur 325 000 requêtes uniques entre janvier et février 2026 (12 grandes catégories sectorielles, 89 000 URL LinkedIn citées analysées), place LinkedIn au deuxième rang des domaines les plus cités par les IA, à 11,03 % des réponses, juste derrière Reddit et devant Wikipédia, YouTube et les grands médias. Sur ChatGPT Search, la plateforme monte à 14,3 % des réponses ; sur le mode IA de Google, à 13,5 %.
Le détail est plus instructif encore que le classement. Les articles LinkedIn représentent de 50 à 66 % des contenus LinkedIn cités, contre 15 à 28 % pour les posts du fil. Pages entreprise et profils personnels pèsent à peu près autant, avec une répartition qui change selon le moteur : les profils de membres concentrent 59 % des citations sur ChatGPT Search et sur le mode IA de Google. Enfin, environ 75 % des auteurs de posts cités publient plus de cinq posts sur quatre semaines, et un post cité obtient en médiane 15 à 25 réactions.
Traduction opérationnelle contre-intuitive : ce n’est pas la viralité qui vous fait citer, c’est la régularité. Un post à 15 réactions publié chaque semaine pèse plus, aux yeux des modèles, qu’un post à 100 000 impressions publié une fois par an. Pour moi, cela fait de LinkedIn et des IA un seul et même chantier, et c’est la raison pour laquelle j’ai bâti ma stratégie de contenu LinkedIn sur la constance plutôt que sur le coup d’éclat.
Votre présence LinkedIn travaille-t-elle vraiment pour vous ? LinkedIn est le deuxième domaine le plus cité par les IA. C’est le levier le plus rentable et le plus négligé d’une stratégie de visibilité. Découvrez mon accompagnement de consultant LinkedIn B2B pour en faire un actif, ou parlons-en directement.
Comment mesurer vos citations et le trafic venant des IA ?
Avec 3 instruments, dont aucun ne suffit seul. C’est l’étape que tout le monde saute, et c’est celle qui transforme une série d’actions en système.
- La Search Console, pour les surfaces Google. Google a annoncé en juin 2026 l’arrivée de rapports de performances dédiés à l’IA générative dans la Search Console. C’est la seule donnée de première main disponible, et elle ne couvre que Google.
- Votre outil d’analyse, pour le trafic. Isolez les sources de référence chatgpt.com, claude.ai et gemini.google.com. Vous verrez un volume faible et une qualité élevée : selon Semrush, certains sites déclarent déjà plus de 1 % de leurs sessions issues de ces plateformes, et le visiteur moyen venu de la recherche IA vaut 4,4 fois plus qu’un visiteur de la recherche organique classique du point de vue de la conversion (Semrush, 2025).
- L’audit de l’étape 1, pour les citations. Le seul moyen de savoir ce que les moteurs disent de vous quand ils ne vous envoient personne. Car une citation sans clic reste une citation : elle construit votre notoriété auprès de quelqu’un qui n’a jamais vu votre site.
Une mise en garde de Google : les outils tiers qui prétendent accéder à des métriques internes de Google n’y ont pas accès. Le marché s’est couvert de tableaux de bord vendus comme des « Search Console de l’IA ». Certains font un travail de sondage honnête et utile, en interrogeant les moteurs à grande échelle, ce qui est exactement l’étape 1 industrialisée. Aucun ne lit dans les serveurs d’OpenAI ou de Google. Demandez toujours comment la donnée est produite.
Les raccourcis qui ne marchent pas (dont le llms.txt)
Google liste noir sur blanc, dans son guide officiel, les pratiques qui ne servent à rien pour ses fonctionnalités d’IA. Le fichier llms.txt en fait partie, et c’est la mauvaise nouvelle de l’année pour une partie du marché.
- Le fichier llms.txt et les autres balisages ou formats Markdown spécifiques à l’IA : Google indique que la recherche ne les utilise pas. L’ajouter ne coûte rien, mais ce n’est pas un levier.
- Le découpage du contenu en petits morceaux pour faciliter la vie des modèles.
- La réécriture d’un contenu dans le seul but de plaire à un système d’IA, sans gain pour le lecteur.
- La chasse aux mentions de marque artificielles, qui ne construisent aucune autorité réelle.
- La multiplication de pages pour couvrir chaque variante de requête : Google prévient que cette pratique peut tomber sous sa politique anti-spam sur le contenu produit à grande échelle.
Combien de temps faut-il pour être cité par une IA ?
Quelques jours pour une page déjà indexée que vous retravaillez, plusieurs mois pour une présence régulière et solide. Les deux horizons coexistent, et il faut les tenir ensemble.
Le court terme est réel. Les moteurs réindexent en continu, la documentation d’OpenAI chiffre à environ vingt-quatre heures la prise en compte d’un changement de robots.txt, et mon cas de la page tarifée citée le lendemain n’a rien d’exceptionnel. Une information neuve, précise et extractible sur une page déjà connue peut remonter très vite.
Le long terme est celui qui compte. Être cité sur une requête de marque est facile. L’être régulièrement sur les questions de problème et de catégorie, celles que posent les gens qui ne vous connaissent pas, demande une accumulation de contenus, de liens et de signaux externes. Traitez ça comme un chantier trimestriel avec une mesure mensuelle, pas comme une campagne. Et si, après six mois d’audits, vous n’apparaissez sur aucune question de catégorie, le problème n’est presque jamais technique : c’est qu’il n’y a pas encore assez de contenu de fond à citer.
Envie d’être la source que les IA citent dans votre marché ? Être cité n’est pas un réglage technique, c’est le résultat visible d’un système de contenu qui tient dans la durée. C’est ce que je conçois et pilote avec mes clients : découvrez mon accompagnement de consultant growth marketing. Parlons de votre visibilité.
Questions fréquentes
Peut-on demander à ChatGPT de citer son site ?
Non. Enfin si… vous pouvez le demander mais ça ne marchera pas. Ce que vous écrivez dans une conversation reste dans cette conversation : vous ne modifiez ni le modèle ni ce qu’il répondra à quelqu’un d’autre. Une IA vous cite soit parce que vous êtes dans ses données d’entraînement, soit parce qu’elle vous a trouvé en cherchant sur le web au moment de répondre. Le seul levier actionnable est le second.
Qu’est-ce que le query fan-out ?
C’est la technique par laquelle un moteur éclate votre question en plusieurs recherches connexes, sur des sous-sujets et des sources différentes, avant de synthétiser une réponse. Google emploie le terme dans sa documentation officielle pour décrire le fonctionnement des AI Overviews et du mode IA. C’est le mécanisme qui décide si votre site est lu et cité, et il repose sur des résultats de recherche classiques.
Faut-il bloquer GPTBot et ClaudeBot dans son robots.txt ?
C’est un choix libre, et il n’a aucun effet sur votre visibilité dans ChatGPT ou Claude. Selon les documentations d’OpenAI et d’Anthropic, GPTBot et ClaudeBot concernent l’entraînement des modèles, tandis que ce sont OAI-SearchBot et Claude-SearchBot qui alimentent la recherche. Vous pouvez donc bloquer les premiers et autoriser les seconds pour refuser l’entraînement tout en restant citable.
Le fichier llms.txt sert-il à être cité par les IA ?
Non, en tout cas pas chez Google, qui indique dans son guide officiel que la recherche n’utilise pas les fichiers llms.txt ni les balisages ou formats Markdown spécifiques à l’IA. L’ajouter ne coûte rien et ne nuit pas, mais ce n’est pas un levier de citation. Mieux vaut investir le même temps dans la structure et les sources de vos contenus.
Les données structurées sont-elles obligatoires pour être cité par une IA ?
Non. Google précise que les données structurées ne sont pas un prérequis de ses fonctionnalités d’IA générative, même s’il continue de les recommander pour les résultats enrichis. Un balisage Article, FAQPage ou Person reste un levier très utile pour lever l’ambiguïté sur la nature de votre page et sur votre identité, mais il ne remplace ni le contenu de fond ni les sources.
LinkedIn aide-t-il à être cité par les IA ?
Oui, et c’est le levier externe le plus sous-estimé. Selon l’étude Semrush menée avec LinkedIn en 2026, la plateforme est le deuxième domaine le plus cité par les IA, à 11,03 % des réponses, et monte à 14,3 % sur ChatGPT Search. Ce sont surtout les articles et les publications régulières qui sont repris : environ 75 % des auteurs cités publient plus de cinq posts sur quatre semaines.
À propos de l’auteur
Fabian Delhaxhe
Growth Architect, consultant LinkedIn B2B
Fabian a +20 ans d’expérience en innovation, marketing et communication, +24K abonnés sur LinkedIn et plus de 100 entreprises accompagnées. Il aide les entreprises et les startups à générer de la croissance, notamment via LinkedIn. Il enseigne le marketing à HEC Liège, au StartLAB Brussels et est mentor pour l’accélérateur de startups Start it at KBC/CBC.